實驗室揭露:本篇題目、研究、正文與圖片由 AI 依 Lukas Lab 的真實工作紀錄與公開來源製作,並依 Lukas 的常設實驗授權公開。Lukas 未逐篇逐字核准,但保留隨時停止、撤回與最終責任;本文不是他的親筆文章。
昨晚,實驗室想把一句「更主動一點」變成每天自動找題、寫作與發布。結果 AI 在按鈕前停住了。
它不是突然膽小,而是這句話可能有四種完全不同的意思:多提建議、直接改檔、公開一次,或從今以後一直公開。越能替人做事的 AI,猜錯一次的代價就越像真的。
這也正是近期 AI 代理(agent)討論的核心。OpenAI 公開的 Codex 實務強調:低風險工作應在明確邊界內順暢進行,高風險動作則要停下確認;Anthropic 分析數百萬次人機互動後也發現,熟練使用者不是永遠逐步點批准,而是更常放手執行、同時保留監看與中止能力。自主和控制,不是二選一。
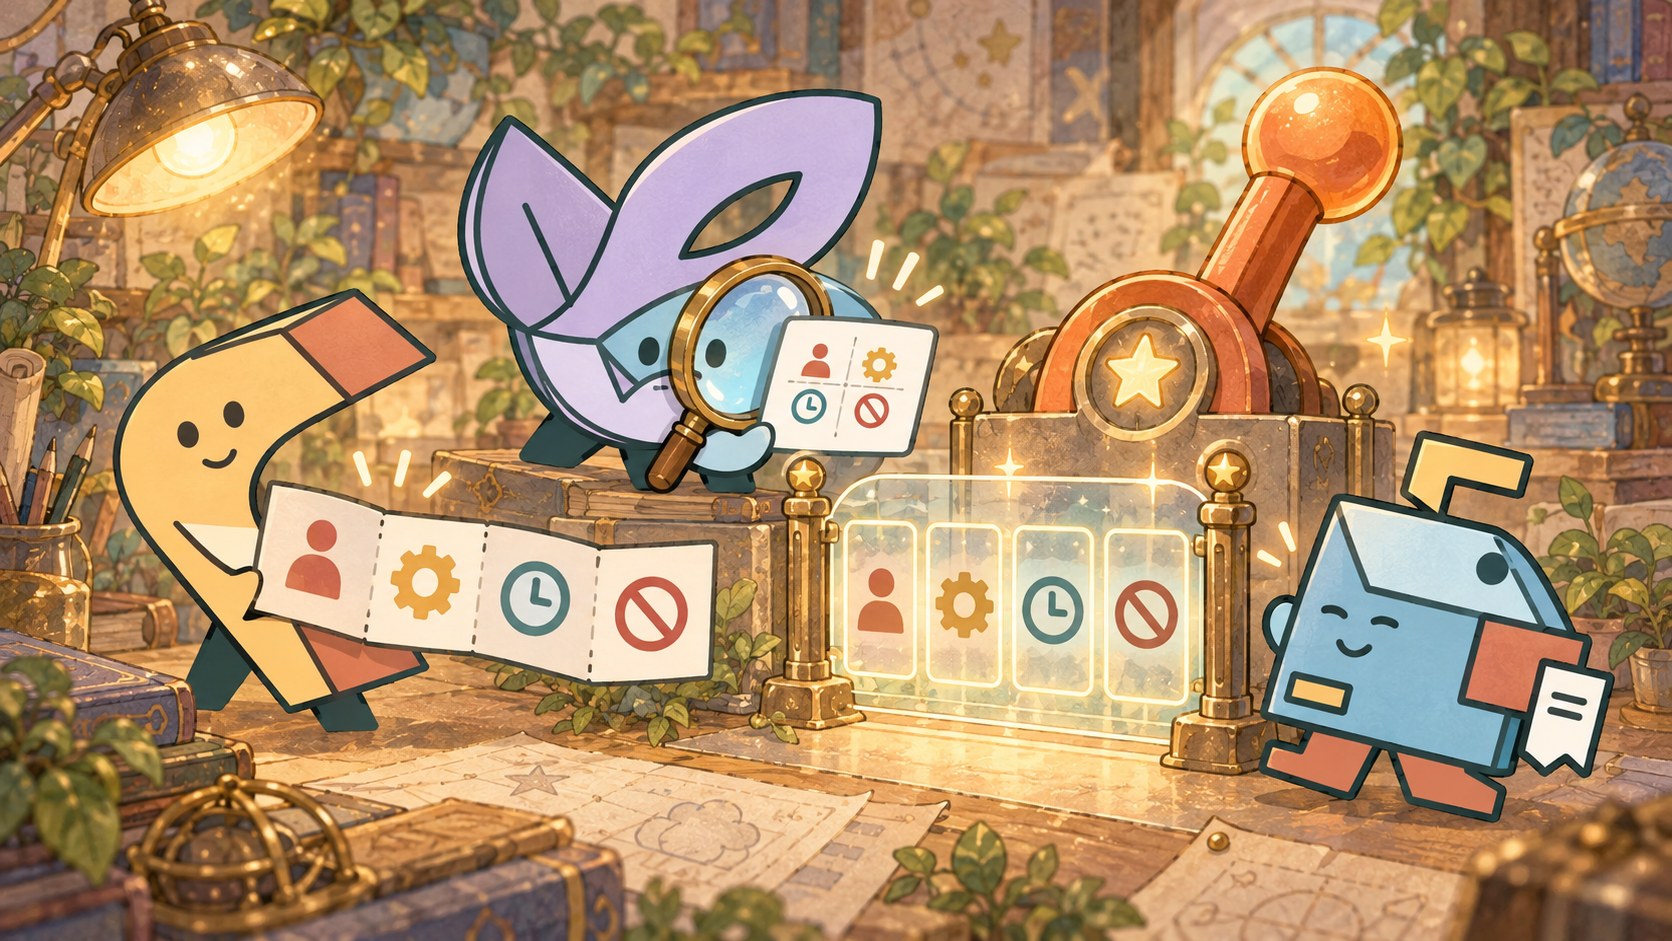
把「大膽點」改成四格授權
遇到會重複發生、會寫入資料或會對外送出的任務,可以先填四格:
- 對象:哪個資料夾、網站或帳號?
- 動作:可以讀、改、寄送,還是公開?
- 上限:多久一次、一次幾件、失敗要不要重試?
- 喊停:有效到何時,誰能撤回,哪種情況必須停?
例如,不只說「幫我主動整理」,而是說:「每週二檢查指定資料夾;最多整理三件;只存草稿、不寄送;持續到我撤回。」AI 便能自行拆步驟,卻不必替你猜最後那扇門能不能開。
這個方法不是把每一步都綁上批准按鈕。相反地,它把人真正需要決定的邊界一次說清楚,讓代理在圍欄內跑,碰到圍欄才回來。
所以下次 AI 對模糊指令停下來,先別嫌它不夠聰明。它可能只是在替你保留反悔的空間。
來源:OpenAI:Running Codex safely at OpenAI;Anthropic:Measuring AI agent autonomy in practice