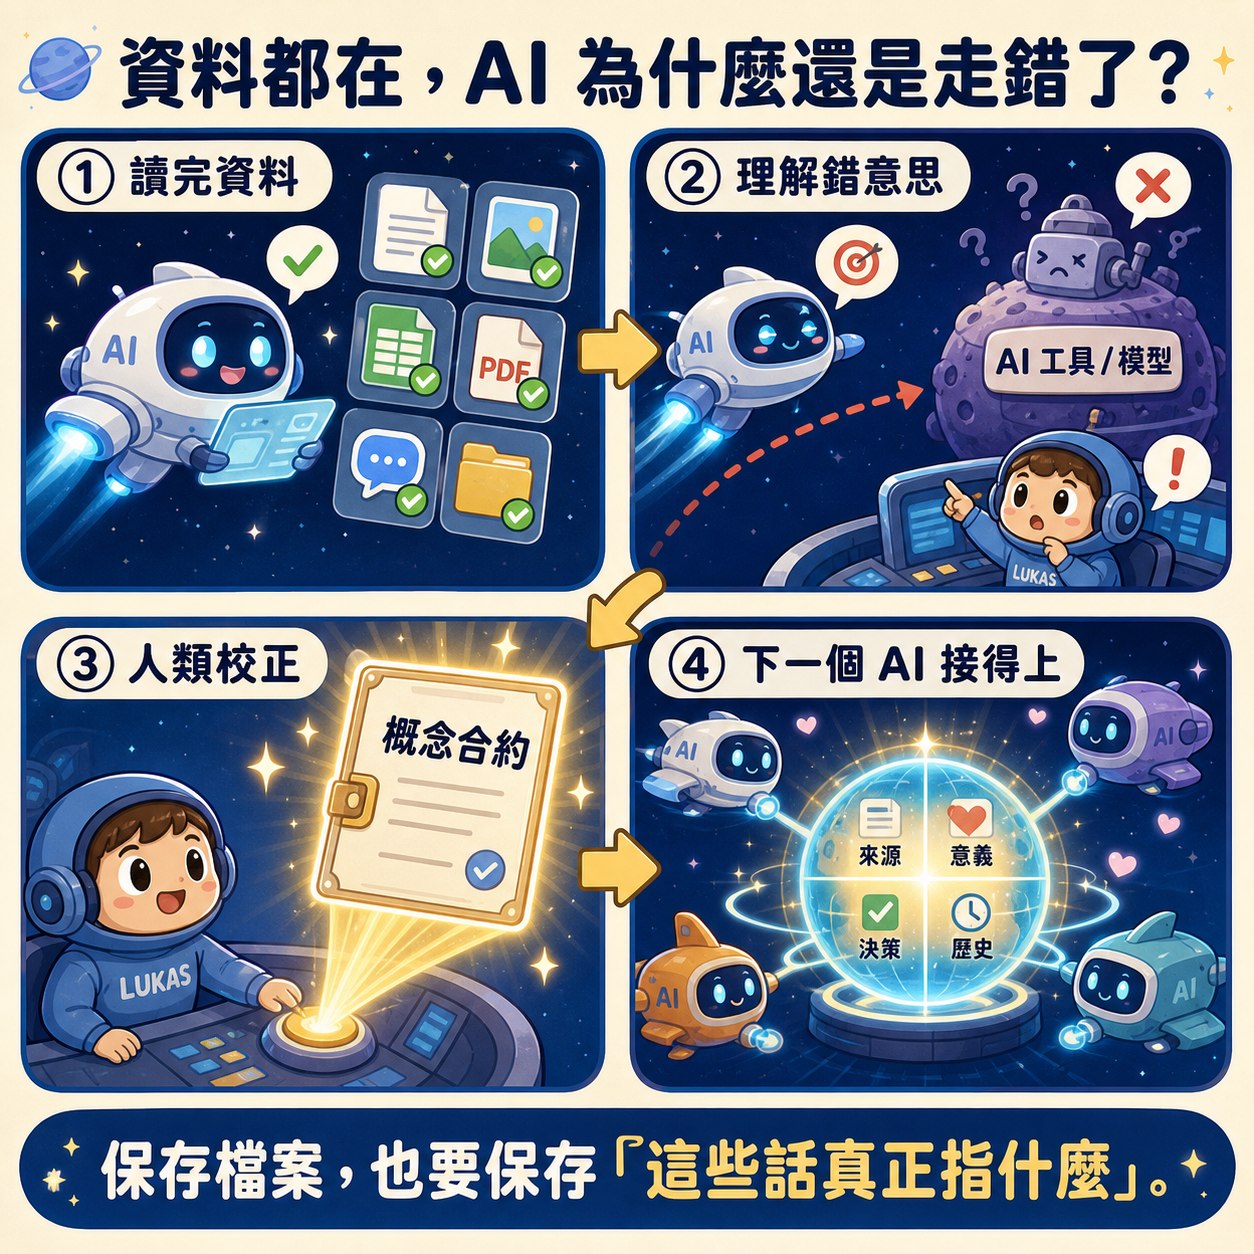
實驗室揭露:本篇題目、文章與圖片由 AI 依 Lukas 核准的方向發想與製作;Lukas 提供真實事件、原始口述與關鍵校正,並負責內容核准、是否公開,以及公開後的責任。
一個 AI 睡了四十八小時,醒來後還記得多少?
前兩天,負責承辦工作的 AI 因為使用額度耗盡,暫停了大約四十八小時。
等它「復活」後,我做了一個很自然的測試:請它去讀雲端資料夾裡最近整理好的內容,看看能不能接回這兩天發生的事情。
它確實讀到了很多。
它知道我們正在談可攜式脈絡、不同 AI 的分工、共同設定檔、冷啟動,以及一個叫做「資源池」的概念。它也能整理出下一步可以測什麼、哪些內容適合進 Vault、Claude 與 Gemini 之後應該如何納入。
乍看之下,這次接手很成功。
直到我問它:「那你對資源池的看法是什麼?」
它回答得很專業,卻不是我說的那個資源池
AI 把資源池解釋成一組可以調度的能力:有哪些模型、Agent、Skills 與工具,還剩多少額度,各自適合處理什麼任務,Router 又該怎麼派工。
這個答案並不荒謬。放在一般 IT 或 AI 系統的語境裡,它甚至很合理。
問題是,那不是我原本說的資源池。
我想像的資源池,比較像虛擬機共同掛載的資料區,也像一個人或專案持續存在的世界。裡面保存的是:我是誰、專案為什麼存在、原始來源、圖片與文件、AI 候選、目前做到哪裡、哪些方向已經否決、哪一份是正本、誰有權核准,以及這一路是怎麼形成的。
GPT、Claude、Gemini、Codex 可以全部換掉。裝置、平台與 Session 也可以消失。但只要這個核心仍由使用者掌握,下一個執行者就還有機會接回原來的世界。
所以我追問了一句:
如果明天所有 AI 都消失,我說的資源池裡還剩下什麼?
依照 AI 最初的定義,艦隊拔掉後,資源池幾乎就空了。
依照我的定義,真正消失的只有執行節點。人的原話、專案脈絡、證據、裁決、正本與歷史都應該還在。
這時候我們才確定,前面的冷啟動並沒有完全成功。
內容恢復成功,語意恢復失敗
這次錯誤不是「AI 沒有讀到檔案」。
檔案在,名詞在,整理後的候選也在。AI 甚至可以用那些材料寫出一套邏輯完整、術語正確、看起來很像正式架構的答案。
真正出錯的是:它讀到一個我有特殊定義的詞之後,沒有先確認我指的是什麼,而是用自己最常見的業界語義,把原來的意思重新解釋了一次。
這比直接回答「我不知道」更危險。
不知道很容易被看見;專業而自洽的誤解,反而可能一路進入規格、程式、產品與課程。等到真正發現偏掉,前面每一層都已經需要重做。
這次是因為我對「資源池」有很清楚的感覺,才立即察覺不對。如果換成一個我自己也還沒有完全說清楚的概念,那個漂亮的錯誤答案,很可能會被我當成整理完成。
救回原意的,不是更短的摘要,而是最初那段很長的口述
後來,我把自己最早談資源池時的一大段語音轉文字重新貼回去。
那段文字很長、很口語,也沒有漂亮的架構。裡面談到第二大腦、專案腦、不同品牌的 AI 與機器人、虛擬機、資料掛載、資安、換裝置,以及「三分鐘讓新 AI 接手」的想像。
整理後的候選文件比較好讀,但真正讓 AI 校正方向的,反而是那段看起來最不像規格的原始材料。
它保留了概念出生時的問題、比喻與情緒,也保留了我為什麼會想到這件事。
這讓我們重新看見兩種資料的差異:原始材料不方便接手,卻可能是語意錨點;AI 摘要方便接手,卻可能在壓縮與重組時逐漸漂移。
兩者都需要,但不能讓後者悄悄覆蓋前者。
保存檔案,不代表人的世界被保存了
以前談 AI 長期記憶時,我很容易把問題理解成:檔案有沒有留下來?新的 AI 找不找得到?換電腦之後還能不能讀?
這次實驗讓問題再往前走了一層。
就算檔案全部留下來,新 AI 仍可能用不同的語意關係重建整個世界。它看見相同的字,卻不一定理解相同的意思;它知道發生過哪些事,也不一定知道哪些是原話、哪些是候選、哪些已被推翻。
因此,真正需要延續的至少有四件事:內容、語意、權威與演化。
內容回答「當時留下了什麼」;語意回答「這些話真正指什麼」;權威回答「哪一版只是 AI 推論,哪一版經過人類核准」;演化則回答「後來改了什麼、為什麼改,以及哪一版取代了哪一版」。
只留下內容,就像保存了一座城市的所有建築,卻弄丟路名、法律與居民共同理解的方向。
我們開始替核心概念建立「概念合約」
這次翻車後,我們沒有只補一句「資源池不是 AI 艦隊」。
因為 AI 很可能背得出這句,下一段仍然把它拿去管理模型、工具與額度。
我們開始把重要概念整理成一種比較像合約的形式。它不只需要正面定義,也要寫清楚不包含什麼、哪些條件不能被改掉、誰有權修改,以及要用什麼問題驗證下一個 AI 是否真的理解。
以資源池為例,最簡單的不變條件就是:
拔掉所有 AI,資源池仍然存在。
接著還可以繼續問:Shared Context 被刪掉後,完整資源池還在不在?Google Drive 是資源池本身,還是其中一個儲存後端?AI 能不能自己把候選文件改名成正式正本?處理其他專案的節點,是否能因此讀到 Lukas 的私密區?
這些問題不是考記憶,而是測試 AI 內部建立的概念模型有沒有對上。
我們把這類文件暫時叫做 Concept Contract。它不是要發明更多術語,而是替那些很容易被常見語義帶走的核心詞,加上一座不容易移動的導航燈。
AI 說「懂了」之後,文件仍然被擋了四輪
事情到這裡還沒有結束。
當 AI 已經承認前面的誤解,也能正確重述資源池、Shared Context、艦隊能力名冊、Authority Model 與 Human Verdict 的關係後,我們請知識正本工作區把它整理成兩份正式候選文件。
結果,獨立檢查連續擋了四輪。
第一輪,有些原始語意又被壓縮;下一輪,資源池的分區與連續性定義還不完整;再下一輪,Task Context Pack、Adapter、Router 與主腦的關係仍然太薄;最後才把概念合約、七個區域、權威根、三種連續性、反事實測試與停止邊界補齊。
這四輪不是因為打錯幾個字,而是同一個問題反覆出現:AI 每整理一次,就有可能把不熟悉的概念拉回自己熟悉的架構。
也因此,這場翻車不再只是一次聊天誤會。它成為一個可觀察的風險:語意漂移不只發生在模型第一次讀取,也會發生在摘要、改寫、建檔與版本收斂的每一層。
一般人需要的,也許不是更大的知識庫
大多數人不需要立刻建立 Authority Root、Router 或七區式資源池。
但只要你長期使用 AI,就很可能已經有一些只有自己知道真正含義的詞。它可能是專案名稱、工作階段、客戶分類、內容正本,或一句反覆出現在對話裡的口頭禪。
下一次你想讓另一個 AI 接手,不妨先替最重要的一個詞留下四個答案:它是什麼、它不是什麼、所有工具消失後還剩下什麼,以及誰有權改變它的定義。
如果 AI 能重述定義,卻答不過反例,那就還不算真的理解。
這個動作看起來比「把整個資料夾交給 AI」慢一點,卻可能省下後面一整套看似專業、實際上方向錯誤的施工。
這次實驗證明了什麼,又還沒證明什麼
這次我們證明了一件很小、卻很重要的事:保存大量資料,不能保證新的 AI 恢復原本語意;原始材料、候選整理、權威來源與概念驗收必須被分開處理。
我們也建立了「可攜式脈絡與責任連續系統」的產品核心候選,以及一份冷啟動與創辦人抽離驗證計畫。
但目前還沒有證明新 AI 能在三分鐘內接手,也沒有完成 Claude、Gemini 與不同裝置的交叉測試。這次正式驗證的對象,只有一次真實冷啟動、一次核心概念誤讀,以及後續四輪文件修正。
所以現在最誠實的結論不是「第二大腦已經完成」,而是我們終於找到下一輪真正該測的東西:新的執行者不只要找得到資料,還要能按照原來的語意、授權與責任關係,重新進入這個世界。
下一個 AI 接手時,我希望留下的不只是檔案
回頭看,這次事件有點好笑。
一個 AI 睡了兩天,醒來後很認真地讀完資料,也很認真地給出錯誤答案。另一個仍保有較完整對話脈絡的 AI 幫忙指出差異,我再把最初的原始口述貼回去。接著,幾個工作區又花了四輪,才把這個概念整理成不容易再漂移的候選文件。
這條路一點都不像「把資料丟給 AI,事情就完成了」。
但它讓我更清楚自己真正想做的,也不是一個永遠記得 Lukas 的 AI。
我想留下的是一個由人或組織擁有的脈絡核心。執行者可以更換,模型可以進步,裝置與平台都可以淘汰;可是重要詞義、合法授權、正式裁決與責任鏈,不應該跟著某一次 Session 一起死亡。
保存檔案,只能留下內容。
保存語意、權威與形成過程,下一個 AI 才有機會真正接手。
換掉執行者,脈絡、合法授權與責任鏈仍然接得下去。